この記事は中国語版を AI が翻訳したものです。内容に相違がある場合は中国語版を正とします。
最近、顧客から新しい技術テーマの相談がありました。長年蓄積してきた車両信号のデータレイクに対して、意味モデリングとデータガバナンスを行い、将来そのデータを AI Agent と組み合わせて活かしたいという内容です。
相談を受けた後、まず理論面を調べてみました。突き詰めると「ontologyを実際のエンジニアリングでどう使うか」という話です。振り返ってみると、過去の現場でも似たような取り組みは断片的にありましたが、体系立った形にはなっていませんでした。
そこで今回は小さなデモを作り、ontologyの実践概念を一通り整理してみました。この記事では学習の過程と、デモが理論と実装をどう結び付けたかを記録します。
実践における Ontology の中身
実践で使う ontology は、一般に4つの要素から成ります。概念、マッピング、関係、ルールです。
ざっくり整理すると、こうなります。
- 概念:業務オブジェクトとその意味、単位、よく使う呼び方を定義する。
- マッピング:概念と物理的な保存場所の対応を記録する。
- 関係:概念同士の帰属や関連を表し、クエリで複数テーブルを結合すべきかを決める。
- ルール:しきい値や継続時間など、業務上の判断基準を記録する。
言い換えると、データベースが数値を記録するのに対し、ontology は数値の意味・場所・使い方を記録します。
概念を整理するときは、業務上の問いや現場の用語から出発し、同じ意味の呼び方をひとつの概念にまとめ、エンティティと計測値を区別します。車両やバッテリーのようなエンティティは業務オブジェクトを表し、バッテリー温度や車速のような計測値は観測できる数値を表します。単位や別名も付けておくと、言い回しが違っても検索で拾えます。
マッピングを作るときは、先に物理テーブルとカラムを棚卸しし、概念から table.column への対応を一か所にまとめます。ひとつの概念に対応する場所はひとつに絞り、クエリはマッピングに従ってデータを取り、コード各所にテーブル名を直書きしません。出所の違う同義フィールドは、先に定義をそろえてからマッピングに書きます。
関係を整理するときは、帰属と関連を記録します。帰属はその概念が誰に属するかを示し、関連はどの概念を組み合わせて問う必要があるかを示します。関連がある2概念のクエリは JOIN が要り、関連がなければそれぞれ単独で問えます。
ルールを蓄積するときは、業務判断を実行可能な定義として書きます。対象の概念、比較方法、しきい値、単位、継続時間を含めます。しきい値はコードではなくルール側に置くので、基準が変わってもルールを直すだけで済みます。
デモの背景:3層構成と4つの画面
このデモは車両信号データを模したものです。車両3台、テーブル5つで、車両基本情報、バッテリー計測、車両計測、ブレーキ計測をカバーし、時間インデックスを備えます。
データは業務ロジックに沿って生成します。1日あたり2〜3の走行時間帯を設け、停車時は車速がほぼ0、走行で放電し夜間に満充電まで戻り、温度は普段30〜45度の範囲で車速に連動して上下し、ときどき50度超の高温が続き、ブレーキは普段0〜100 barで、たまに150 bar超の急ブレーキが入ります。
システムは3層構成です。上層が意味層、下層が SQLite、中間が Agent です。リクエストは先に意味を調べ、次に SQL を組み立て、最後にデータベースを叩きます。
flowchart TD
    U[ユーザーの質問] --> A[Agent]
    A --> S[意味層]
    S --> Q[Query Plan]
    Q --> SQL[SQL]
    SQL --> DB[(SQLite)]
    DB --> R[行を取得]
    R --> A
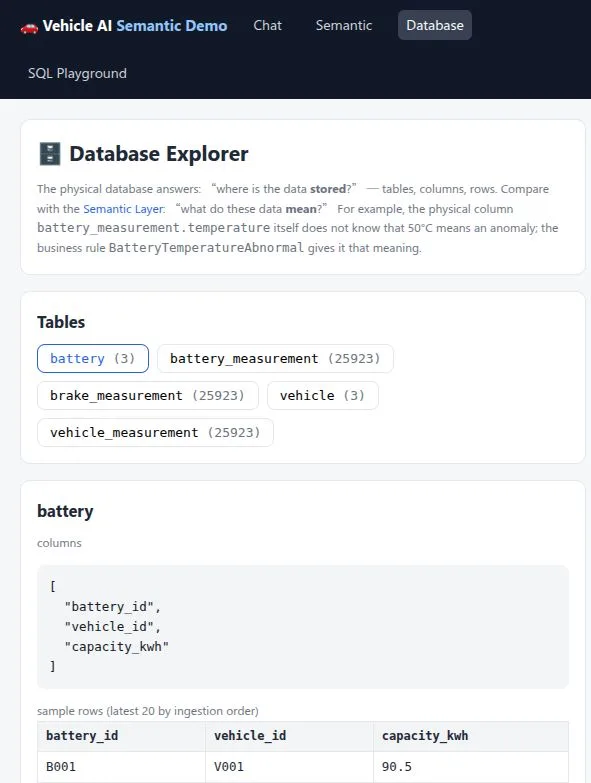
画面は4つです。チャット、意味ブラウザ、データベースブラウザ、SQL 練習場です。質問はチャット画面で行い、マッピングの確認と変更は意味画面で行います。
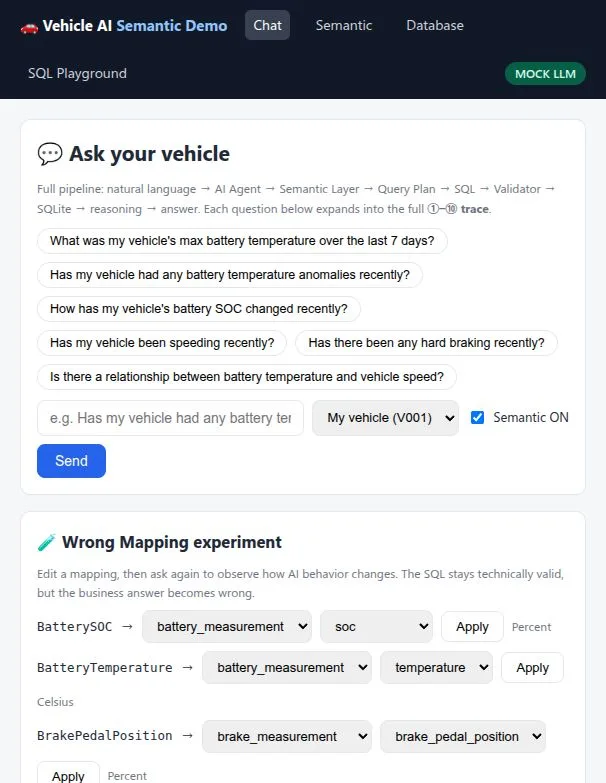
物理テーブルの抜き打ち確認はデータベース画面で行います。battery テーブルを例に取ると、カラムとサンプル行が見えます。
コア設計:4つの JSON ファイルの役割分担
デモの技術スタックはシンプルです。バックエンドは Go(標準ライブラリ net/http で公開)、データベースは SQLite(pure Go の modernc.org/sqlite ドライバで CGO 不要)、意味層はローカルの JSON ファイル、フロントエンドはフレームワークなしの HTML + CSS + Vanilla JS です。Agent の駆動は2種類で、既定は MOCK(API Key 不要の決定的なルール経路)、OpenAI 互換の本物 LLM にも対応します。
ディレクトリ構成は次の通りです。
sementic-ai/
├── main.go                  # 組み立て:.env → SQLite+seed → catalog → agent → :8080
├── agent/                   # AI Agent:意図判定、QueryPlan、SQL生成、結果推論
├── semantic/                # 意味層のGo実装:catalog + 検索
├── semantic_data/           # 意味層データ:JSON 4つ
├── database/                # 物理層:SQLiteのテーブル作成、seed、読み取り専用クエリ
├── tools/                   # Agentが呼べる2つのTool:意味検索、SQL実行
├── validator/               # SQL検証:読み取り専用、単文、テーブル allowlist
├── server/                  # net/httpサービス:画面 + JSON API
└── web/                     # フロントエンド:HTML + CSS + Vanilla JS
モデリングの成果物は semantic_data/ 配下の4つの JSON が担います。Go 側の SemanticCatalog は Search / GetMapping / GetRule などのメソッドを持ち、Agent が実行時に呼び出します。
concepts.json には7つの概念が入ります。Vehicle と Battery は entity、BatteryTemperature、BatterySOC、VehicleSpeed、BrakePressure、BrakePedalPosition は measurement です。
"BatteryTemperature": {
  "description": "Temperature measurement of the vehicle battery",
  "type": "measurement",
  "unit": "Celsius",
  "keywords": ["battery temperature", "temperature", "thermal", "overheat"]
}概念には単位やよく使う呼び方(中国語の別名を含む)を付けて意味検索に使います。たとえばブレーキの話題が出れば、BrakePressure と BrakePedalPosition にたどり着けます。
mappings.json は概念と物理的な保存場所の対応を記録します。
"BatteryTemperature": { "table": "battery_measurement", "column": "temperature" },
"VehicleSpeed": { "table": "vehicle_measurement", "column": "speed" }対応関係はここにだけ置きます。agent/ や tools/ の SQL 生成ロジックにテーブル名は直書きせず、実行時に必ず GetMapping() を呼んで問い合わせ先を決めます。
relationships.json は概念同士の関係を表します。
"BatteryTemperature": {
  "belongs_to": ["Battery", "Vehicle"],
  "related_to": ["VehicleSpeed"]
}
has / belongs_to / related_to が、複数概念の問い合わせで JOIN が要るかを決めます。たとえば温度と速度の横断分析が成り立つのは、両者に related_to があるからです。
business_rules.json には業務ルールが3つ入ります。
"BatteryTemperatureAbnormal": {
  "concept": "BatteryTemperature",
  "operator": ">", "threshold": 50,
  "minimum_duration_minutes": 5
}ほかに速度超過120、急ブレーキ150の2つがあります。これらのしきい値はデータベースには存在せず、temperature カラム自体に「50度が異常かどうか」の情報はありません。しきい値はコードではなく JSON に置くので、基準を変えるときはデータファイルを直すだけです。
4ファイルの関係をまとめると、概念が土台、マッピングが概念を table.column に結び付け、関係が複数概念の問い合わせ方を決め、ルールが概念を参照して判断基準を与えます。Agent の実行順もこの流れに沿います。Search で概念を探し、GetMapping / GetRule で場所としきい値を取り、QueryPlan と SQL を組み立てます。
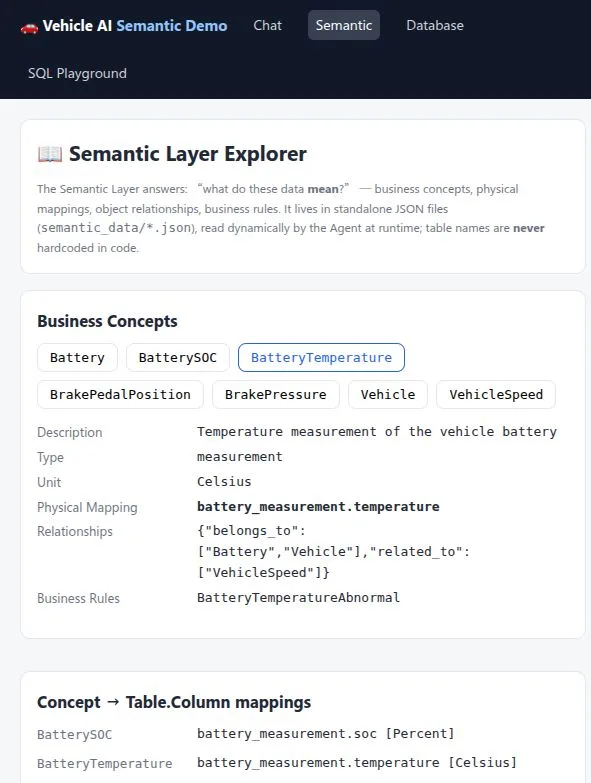
意味画面では上記をまとめて見せます。BatteryTemperature を例に取ると、説明、単位、物理マッピング、関係、ルールが並びます。
JSON はモデリング成果物の置き方のひとつで、規模が小さく変更が頻繁な段階に向きます。同じ内容は RDF/OWL とトリプルストア、プロパティグラフデータベース(Neo4j など)、関係テーブル、設定センターや意味プラットフォーム、コード注釈などの形でも持てます。置き方が違っても、概念・マッピング・関係・ルールの4要素は残ります。変わるのは主に検索、バージョン管理、スケール対応のしやすさです。
質問への回答が一通り動くまで
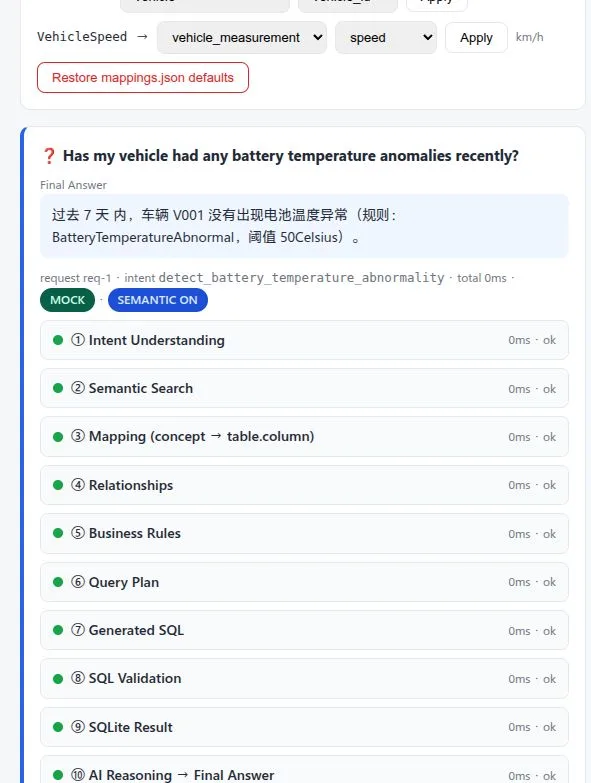
「うちの車、最近バッテリー温度の異常はある?」という質問を例に見ていきます。画面上の Trace を開くと、次の手順が並びます。
まず意図を判定し、バッテリー温度異常の問い合わせ、対象は既定の V001、期間は直近7日間と決めます。次に battery temperature abnormal で意味カタログを検索し、Battery と BatteryTemperature にヒットします。続いて概念名でマッピングを取り、battery_measurement.temperature への問い合わせと決め、ルールから50度・5分継続という基準を取ります。
材料がそろったら QueryPlan を作り、さらに SQL を組み立てます。
SELECT timestamp, temperature AS value FROM battery_measurement
WHERE vehicle_id = 'V001'
AND timestamp >= datetime('now','-7 days')
AND temperature > 50
ORDER BY timestamp
その後、検証とデータベース検索に進みます。この実行では基準を満たす長時間超過が見つからず、最終的に異常なしの中国語回答を返します。
flowchart LR
    Q[質問:最近バッテリー異常はある?] --> I[意図を判定]
    I --> S[意味カタログを検索]
    S --> P[Query Planを作成]
    P --> G[SQLを作成]
    G --> V[検証]
    V --> D[(SQLiteを検索)]
    D --> R[ルールで束ねて回答]
ontology が効く場所は2か所です。ひとつは SQL 組み立てより前で、問い合わせ先としきい値がいずれも意味カタログから来て、直書きではありません。もうひとつは行データを受け取った後で、異常イベントのまとめ方もルールの記述に従います。
下図がこの質問の実際の Trace で、①〜⑩まで全部通っています。
意味層の有無で何が変わるか
チャット画面には意味スイッチ(Semantic ON/OFF)があり、既定でオンです。質問時に semantic_enabled として /api/chat に渡し、Agent が意味カタログを経由するかを切り替えます。オンなら先にカタログを調べてから SQL を作り、オフなら意味手順を飛ばして直接 SQL を作ります。このスイッチは意味層の有無による振る舞いの違いを比べるためのもので、意味画面にはマッピング変更と復元用の接口もあり、マッピング破損の実験に使います。
オンのときは、先に意味カタログを調べてから SQL を作ります。問い合わせ先としきい値はマッピングとルールから来ます。
オフにすると、意味検索、マッピング取得、関係取得、ルール取得をまとめて飛ばし、モデルがテーブル名やカラム名の推測で SQL を書きます。たとえば SELECT temperature FROM battery ... を作ると、検索時に no such column: temperature と怒られます。実際のテーブル名は battery_measurement です。意味層がないと、業務用語の意味(何度から異常か、何分続いたら異常か)も決められません。
もうひとつ、マッピング破損の実験があります。BatteryTemperature のマッピングを temperature から voltage に変え、最高バッテリー温度を聞きます。QueryPlan は MAX(voltage) を示し、SQL は適法、検証は全部通り、データベースは 411.0 をきちんと返し、最終回答は最高 411.0°C になります。経路上でエラーはひとつも出ませんが、業務回答としては明らかにずれます。
2組の比較が示すのは次の点です。SQL の正しさがカバーするのは構文適法、テーブル・カラムの存在、読み取り専用などの条件までです。業務回答の正しさは、概念を探し当てたか、しきい値を正しく使ったかにもかかります。検証は前者を担い、意味層は後者を担います。
この記事では現象面に絞って ontology の構成と動き方を説明しました。バージョン管理、定義の衝突、大規模推論など、さらに踏み込んだ実務テーマは扱っていません。入門段階の参考として読んでもらえればと思います。